Apprentissage automatique · Analyse sportive
CourtSense AI
Un système de prédiction de matchs de tennis et de simulation de tournois.
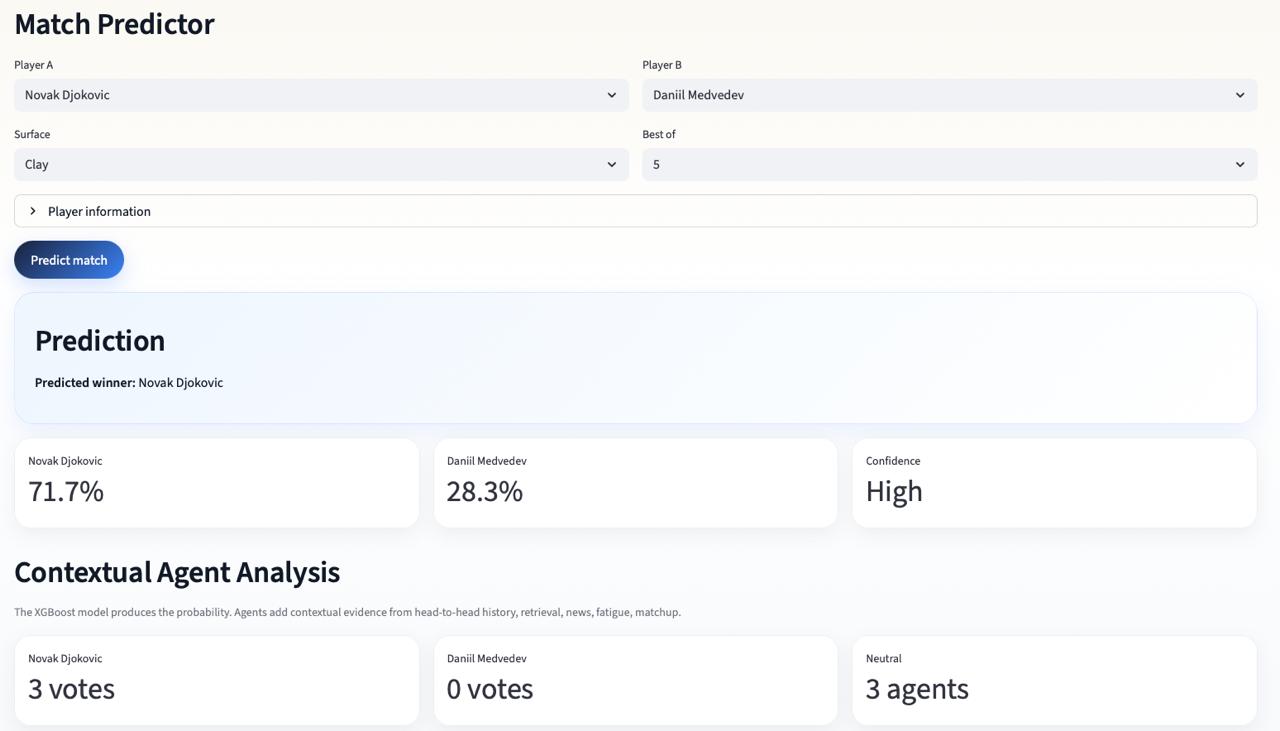
CourtSense AI est un projet d’apprentissage automatique pour prédire les résultats des matchs ATP. Il combine un modèle XGBoost, les classements Elo, la recherche de matchs similaires dans l’historique et des agents d’analyse du contexte.
Le système estime les probabilités de victoire, explique ses prédictions à partir d’éléments de contexte et simule le déroulement de Roland-Garros à partir du tableau officiel.
- Modèle XGBoost entraîné sur l’historique des matchs ATP
- Classements Elo globaux et par surface
- Recherche de matchs similaires par similarité cosinus
- Agents d’analyse des confrontations directes, de la fatigue, des profils des adversaires, de l’actualité et de l’incertitude
- Application Streamlit interactive pour prédire des matchs et simuler des tournois
Vision par ordinateur · IA interactive
Guess What AI Thinks
Un petit jeu construit autour d’un modèle de classification d’images.
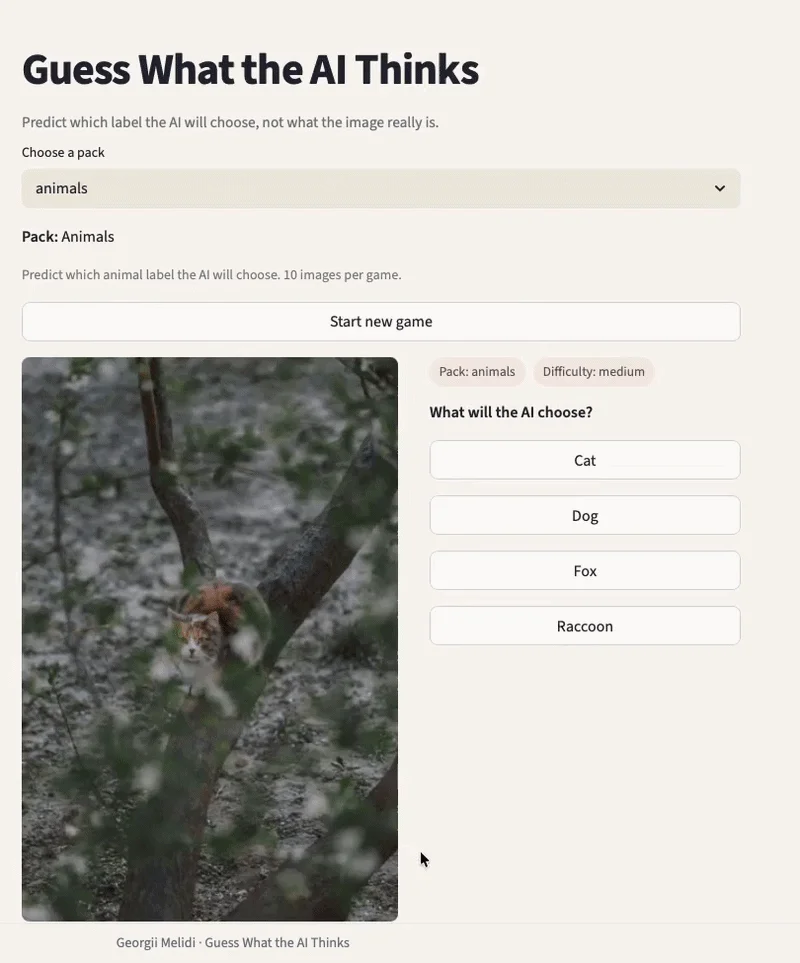
Dans ce jeu, le joueur essaie de deviner ce qu’un modèle va prédire pour une image donnée. Je voulais transformer une tâche classique de classification d’images en quelque chose d’interactif.
Le jeu utilise SigLIP (google/siglip2-base-patch16-224). Au lieu de classes fixes, je définis un ensemble d’étiquettes pour chaque lot d’images. Le modèle évalue la correspondance entre chaque étiquette et l’image ; ces scores sont convertis en probabilités, puis le jeu affiche les prédictions les mieux classées.
- Classification d’images avec SigLIP
- Ensembles d’étiquettes personnalisés plutôt que classes fixes
- Conversion des scores en probabilités pour le classement
- Application Streamlit interactive
Apprentissage par imitation · Planification
Tiny Robot Playground
Un environnement de navigation pour comparer différentes stratégies de décision d’un robot.
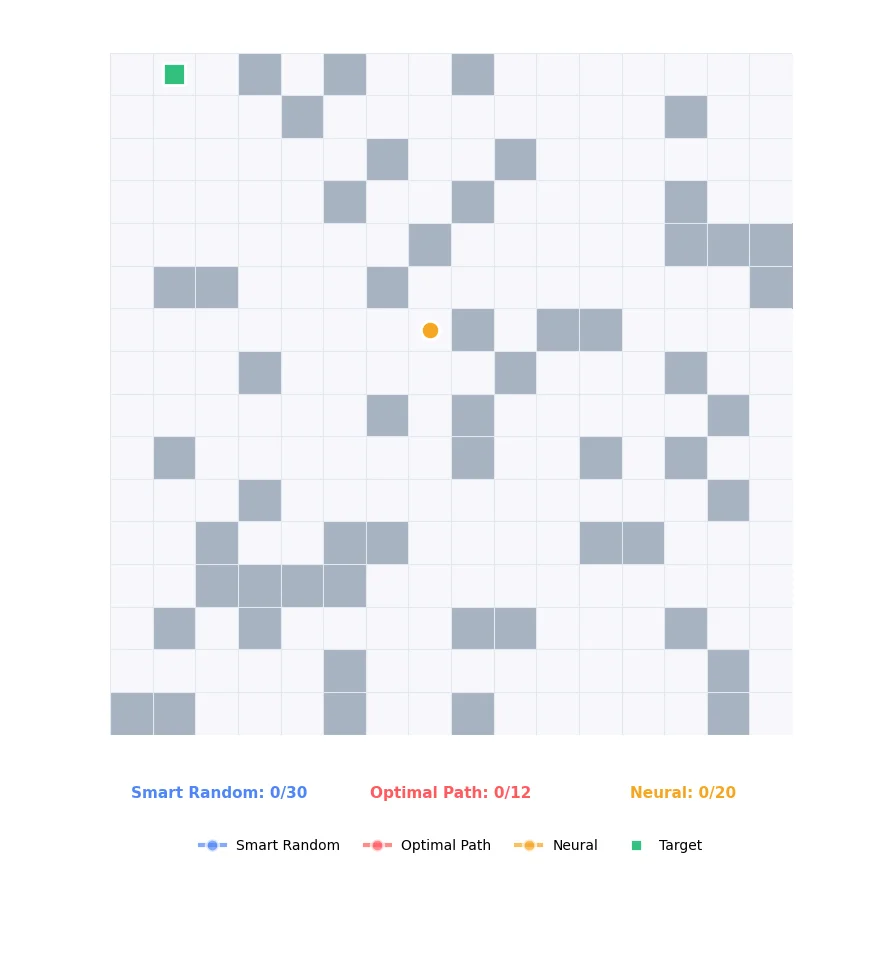
L’idée est simple : placer un robot sur une grille et observer comment différentes méthodes le conduisent à son objectif. La tâche est la même, mais les stratégies se comportent très différemment.
Le robot se déplace sur une grille 2D avec des obstacles générés aléatoirement, et l’objectif reste toujours accessible. On peut régler la difficulté en modifiant la taille de la grille, la densité des obstacles ou la distance à l’objectif.
- Smart Random : se déplace au hasard, mais évite de revenir immédiatement sur ses pas
- Chemin optimal (BFS) : voit toute la grille et suit le chemin le plus court
- Stratégie neuronale : ne voit que son environnement proche et apprend par imitation (PyTorch)
Toutes les stratégies évoluent sur la même grille. On peut ainsi comparer leur taux de réussite, le nombre de pas, les collisions et la récompense. Les différences sautent aux yeux lorsqu’on les observe côte à côte.
Apprentissage par renforcement · Optimisation
RL Dynamic Pricing
Un projet d’apprentissage par renforcement pour ajuster les prix au fil du temps lorsque la demande est incertaine.
Ce projet simule une boutique en ligne dans laquelle le vendeur ajuste ses prix au fil du temps. À chaque étape, des clients arrivent de façon aléatoire et décident d’acheter ou non en fonction du prix. L’objectif est de maximiser le chiffre d’affaires avant l’épuisement du stock.
La demande varie au fil du temps : les arrivées suivent un processus de Poisson, la probabilité d’achat dépend du prix via une sigmoïde, et les ventes sont aléatoires. Les décisions influencent les étapes suivantes, ce qui en fait un cadre intéressant pour l’apprentissage par renforcement.
- Simulateur de demande aléatoire avec un stock limité
- Deep Q-Network (DQN) pour apprendre une stratégie de tarification
- Espace d’actions discret : une grille de prix
- Comparaison avec un prix fixe et des stratégies heuristiques
Un chiffre d’affaires moyen supérieur d’environ 8,5 % à celui obtenu avec un prix fixe.
Sur 50 épisodes d’évaluation dans le simulateur, le DQN a obtenu un chiffre d’affaires moyen d’environ 678, contre 625 avec un prix fixe. Ces résultats concernent cet environnement simulé.